
面对当前算力市场多元异构、群雄并起的格局,如何将不同类型的GPU、NPU纳入统一的管理调度体系,既是算力基础设施演进的现实命题,也在深刻改写行业的运行规则。正处于IPO进程中的特斯联,近期推出升级版T-Cluster 512超节点架构,就此交出了自己的答卷。
T-Cluster 512在高速互联、能效优化与系统稳定性三方面实现全面跃升:互联带宽提升8倍以上,液冷覆盖率超过70%,PUE值低至1.08。以一座1MW的智算中心为例,部署该架构后每年可节电逾10%。然而,这套超节点的真正“灵魂”在于软件——特斯联自研的ThiCP混合智算平台。该平台负责异构算力的统一管理、调度及混合训练推理,通过软硬件协同设计,力图破解混合算力场景下资源闲置与利用率低下的顽疾。
ThiCP平台的核心创新之一,是采用了VCU(虚拟算力单元)。 简言之,VCU将GPU、NPU等算力资源进行标准化抽象,1个VCU等价于10%的物理算力。通过将物理算力与显存解耦,单张算力卡可被多个容器并发共享,打破了过去一个任务独占整卡的“捆绑”模式,实现“按需取用、弹性分配”。同时,平台实时监测VCU使用状况,自动回收闲置的算力碎片,从而将行业通常不足40%的算力利用率提升至80%以上。计费模式亦随之精细化为“VCU/小时”粒度,单台服务器的有效算力产出相当于传统模式的1.5至2台。
在此之上,ThiCP构建了逻辑统一的虚拟资源池。它将分散于不同物理节点的异构算力聚合成池,从调度视角视为一整块资源。调度平台实时采集任务负载、服务质量、用户请求及资源健康度等多维信息,跨节点动态分配与回收资源,有效规避物理资源因静态独占而造成的浪费。
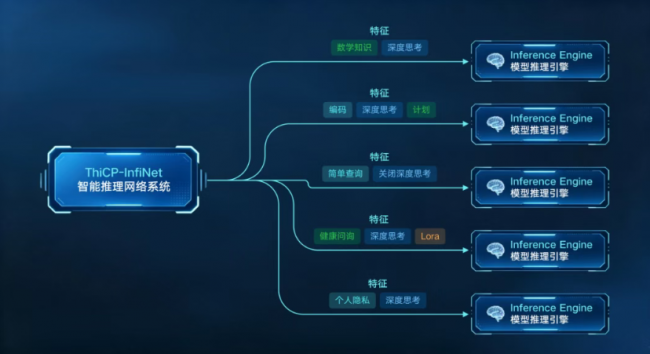
近期,特斯联在ThiCP平台新增了ThiCP-InfiNet智能推理网络系统, 旨在进一步提升Token生产效率,将推理成本压低50%至70%。
其核心是将传统固定路径推理升级为智能分发模式:系统接收推理请求后,从多维度迅速研判——依据简单问答或复杂代码生成等不同场景估算计算量;结合模型实例的响应时延与成本,在低延迟与低成本间寻求最优解;监测GPU利用率、显存占用、队列长度等实时状态;同时执行安全扫描,将高风险请求引导至沙箱环境处理。基于上述分析,系统在毫秒级内做出路由决策,将请求精准匹配至最适配的模型与算力资源。
纵观全局,特斯联从硬件能效优化,到资源虚拟化切分,再到智能推理分发,逐层深入,将算力调度推向精细化运营。这一方案推动了算力从粗放式的资源分配,走向按需取用的服务化模式,为“Token即服务”等新兴商业模式夯实技术底座。
 微信扫一扫打赏
 支付宝扫一扫打赏